最近、サプライチェーン攻撃の話題を耳にするたび、「うちのサービスは本当に大丈夫だろうか」と少し心が落ち着かなくなります。
まして社内外から「サプライチェーン攻撃対策、大丈夫ですよね?」と聞かれると、担当者としては胸がキューっとなってしまいます。
もちろん、依存ライブラリの棚卸しや SBOM の整備など、できる対策はしています。ただ、利用しているライブラリや外部サービスをすべて把握し、潜むリスクをすべて潰していくのは至難の技です。
そこで発想を少し変えました。
侵入を100%防ぐことが難しいのであれば、「万が一、侵入された後の動き」を早く見つけられないだろうか。
サプライチェーン攻撃によって不正なコードが入り込むと、攻撃者が用意した C&C サーバなど、普段は接続しない外部への通信が発生するケースがあります。その「いつもと違う外向き通信」を見つけるための監視システムを作ってみることにしました。
● 100点満点ではなく、80点を目指すことにした
とはいえ、フルパケットキャプチャやプロセス監視は、高度な分析ができる一方、導入・運用コストも相応にかかります。
高機能でログが詳細になるほど、「全部きちんと見なければ」という気持ちになり、結果としてログやアラートが溢れてほとんど見なくなる。これでは本末転倒です。
特に「今すぐ対策を打ちたい」という状況では、最初から高機能な監視基盤を作るのはハードルが高い。
そこで今回は、「100点満点の完璧な検知」ではなく、「80点の検知を継続する」ことを目標にしました。
● 全部のログは集めない。通信先だけを見る
今回使ったのは、AWS で取得できる「DNS ログ」と「VPC フローログ」です。
SIEM のように膨大なログを集めるのではなく、最初から用途を「外向き通信の宛先確認」に絞ります。
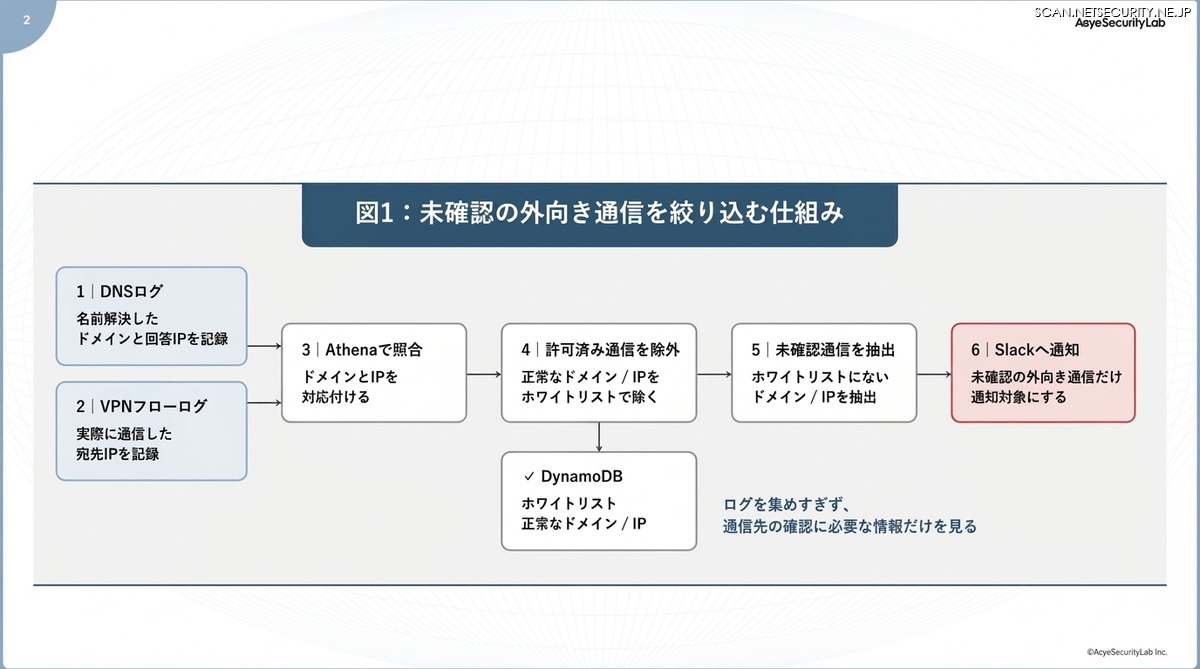
DNS ログから名前解決したドメインと回答 IP を取得し、VPC フローログの通信先 IP と突き合わせます。これにより、ドメインが分かる通信先と、ドメインに対応付けられなかった IP アドレスの一覧を出し、その通信先が正当かを確認できます。
処理の流れは次のとおりです。
DNS ログからドメインと回答 IP を取得
↓
VPC フローログの通信先 IP と突き合わせ
↓
許可済みのドメイン・IP を除外
↓
未確認の通信だけを抽出
↓
Slack へ通知
↓
問題なければホワイトリストへ追加
ポイントは、PC とは違い、一般的な Web サーバや AP サーバが自らアクセスする外部の通信先はそれほど多くないことです。大きな変更がない限り、新しい宛先への通信はほとんど発生しません。
実際に検出される通信先も、パッケージマネージャや OS のシステムが利用する固定的なドメインが中心です。正当だと確認できればホワイトリストへ登録し、以降は通知から除外できます。
● AWS のマネージドサービスで軽く作る
構成には、S3、Athena、DynamoDB、Lambda など、AWS のマネージドサービスを採用。監視用サーバを常時起動して管理する構成ではなく、必要なときだけログを分析・処理するため、メンテナンス負荷やコストも抑えられます。
かつては数百万円規模の投資が必要だったような監視基盤も、この方法なら「1日の工数」と「月数百円程度のコスト」で構築可能です。
● 作って終わりではない。ここからが運用の本番
とはいえ、初回のテストでは、環境によっては未確認の通信が100件以上ヒットすることもあります。OS のアップデートや AWS 内部の通信など、正常な通信も通知対象になるためです。
そこで必要になるのが、最初のチューニングです。通知された通信先を確認し、安全と判断できるドメインや IP を DynamoDB のホワイトリストへ登録していきます。
アラートが数百件あっても、ひとつのドメインを登録するだけで、紐づく複数の IP 通信がまとめて消えることも。こうして正常な通信を除外し、少しずつノイズを減らしていきます。
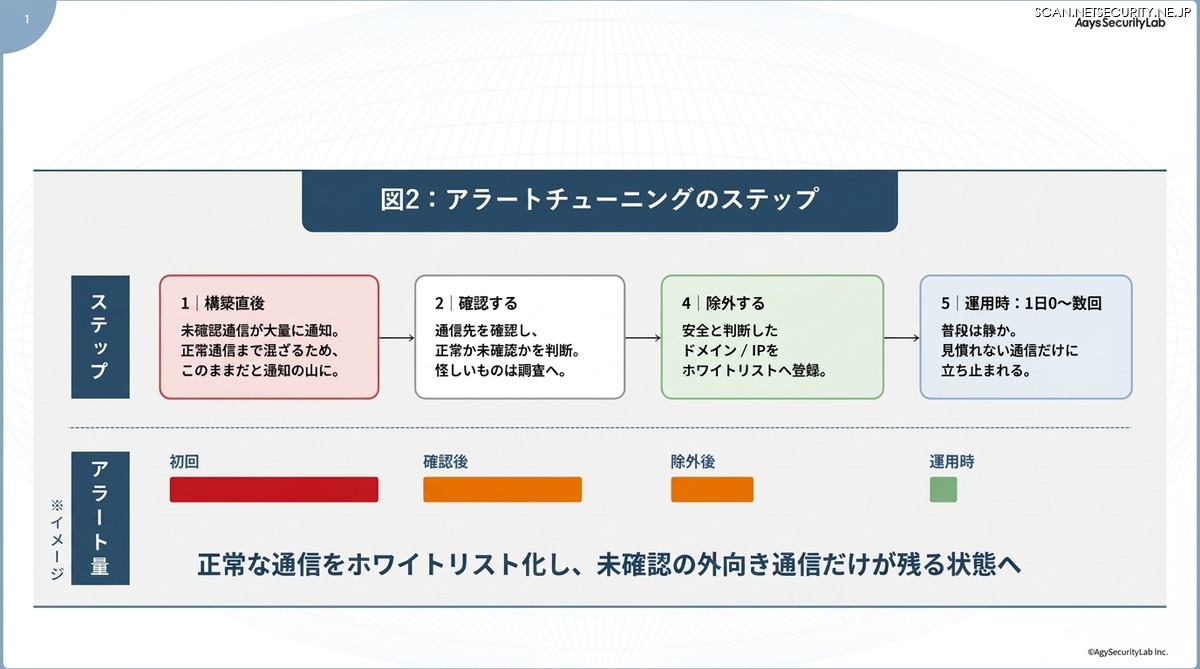
一方、すべてを厳密に分類しようとすれば、その分だけ運用負荷は高まります。正確な用途までは判断しづらくても実害がないと判断できるものはホワイトリストへ。場合によっては、特定の IP レンジを監視対象から外すという割り切りも必要です。
● 普段は何も起きない監視を目指す
もちろん、除外すれば検知できない範囲は生まれます。それでも、アラートが多すぎて無視される状態よりはいい。ここでも「100点ではなく80点」という考え方です。
一般的な Web サーバであれば、フィルタリング後に新しい通信先が頻繁に現れることはありません。Lambda の発火回数も、1日0~数回程度に収まります。
弊社でも、外部へのイレギュラーな通信が少ない環境を中心に監視し、必要に応じてノイズになる IP レンジを除外。可能な限り監視範囲を広く取りつつ、ほぼノイズ0の状態を実現しています。
普段はほとんど何も出ない。だからこそ、ある日突然、見慣れないドメインや IP が Slack に上がってきたときに、「今まで出ていなかったのに、なぜ?」と立ち止まれます。
日々の運用は、通知された通信先を確認し、正当ならホワイトリストへ追加するだけ。確認作業が1日10分を超えるようなら、ホワイトリストや監視範囲を見直します。
● 結局、続けられる監視がいちばん強い
もちろん、この仕組みですべてのサプライチェーン攻撃を検知できるわけではありません。外部の C&C サーバなどへ通信するタイプの攻撃を見つけるための、一つのレイヤーです。
それでも、すべてのログを集めて100点を目指すのではなく、見るべき情報を絞り、普段とは違う通信だけが目に入る状態を作る。
100点を目指して力尽きるより、80点でも毎日続けられる仕組みを作る。
少なくとも次に「サプライチェーン攻撃対策、大丈夫ですよね?」と聞かれたときは、以前より胸がキューっとせずに済みそうです。